vLLM 学习笔记(1):最小的离线示例
这一章不碰源码,也不看任何类的层次。目标只有一个:把”给一个 prompt、让它生成一段话”这件事从概念上想清楚,并搞明白 vLLM 到底在解决什么问题。
先看最小的一段
from vllm import LLM, SamplingParams

llm = LLM(model="Qwen/Qwen3.5-0.8B")
out = llm.generate(["你好,请用一句话介绍你自己"], SamplingParams(temperature=0.8))
print(out[0].outputs[0].text)
这里的 Offline(离线)是说:一批 prompt 一次性喂进去,等结果,不用考虑并发请求、流式返回、服务稳定这些事。它是 vLLM 里最简单、结构最清楚的一个入口,适合拿来开头。
一次生成,其实是两步
大模型生成文字是自回归的:一次只吐一个 token,然后把新 token 接到后面,再吐下一个。所以生成 100 个 token,就是做 100 次前向——1 次 prefill 出第 1 个,再 99 次 decode 出剩下 99 个。
但第一次前向和后面每一次很不一样:
- 第一次要把整个 prompt 从头过一遍,算出所有位置的结果。这一步叫 prefill。
- 之后每一次,只需要处理”最新加进来的那一个 token”——前面那些 token 的结果已经算过了,不用重算。这一步叫 decode。
所以一次生成 = 1 次 prefill + N 次 decode,一共产出 N+1 个 token——prefill 出第 1 个,之后每 decode 一次再出一个。
钉一个具体的例子
用最小的情况把上面的流程走一遍:prompt 是 3 个 token,记作 A、B、C;生成 4 个 token,记作 D、E、F、G。
| 步骤 | 输入 | 输出 | 这步之后 KV cache 里有什么 |
|---|---|---|---|
| prefill | A B C(3 个) | D | A B C |
| decode 1 | D(1 个) | E | A B C D |
| decode 2 | E(1 个) | F | A B C D E |
| decode 3 | F(1 个) | G | A B C D E F |
盯两列看:
输入那一列——只有 prefill 是 3 个 token,后面每次都是 1 个。这里有个容易忽略的点:prefill 也会产出一个 token(D)。它不是”预处理”,它就是第 1 次前向、第 1 个生成结果。
第三列——每一步都在变长,新 token 的 K/V 被追加进去。这一列就是 KV cache。
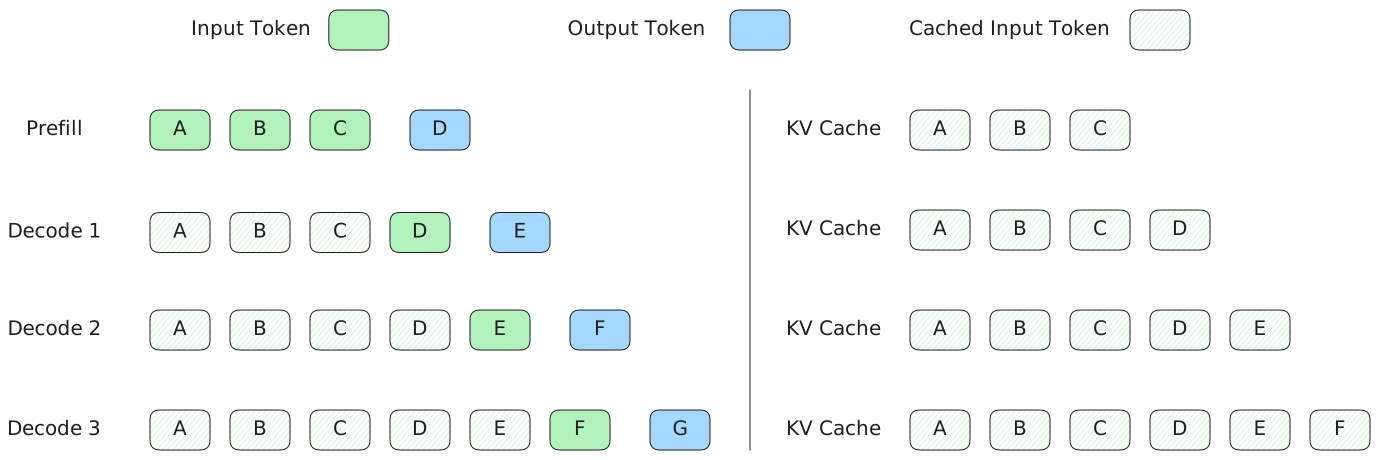
图里四行对应上面四步。绿色是这一步真正喂进去的新 token,斜线的是从 KV cache 读出来的历史,蓝色是这一步产出的 token。输入那一列,prefill 是 3 个、之后都只有 1 个——这个对比就是整张图的重点。
为什么必须缓存:不然每一步都要重算
decode 只输入 1 个 token 也能算,是因为它把 KV cache 里前面所有 token 的 K/V 读出来,和新 token 的 K/V 拼在一起。
反过来想:如果不缓存,每一步都得把 A B C D E F 全部重算一遍。生成第 100 个 token 要算 100 个 token 的量,第 1000 个要算 1000 个——整体是平方级的开销。所以 KV cache 不是”优化项”,是自回归生成能跑起来的前提。
代价是显存,而且浪费得很厉害
KV cache 必须待在显存里。序列越长、并发越多,它越大;长 prompt 配长输出的时候,甚至比模型权重本身还大。
但论文(PagedAttention,SOSP 2023)把问题又往前推了一步。摘要里有句话点得很准:
the KV cache memory for each request is huge and grows and shrinks dynamically. When managed inefficiently, this memory can be significantly wasted by fragmentation and redundant duplication, limiting the batch size.
意思是:KV cache 又大又动态,管理不当就会被碎片和冗余重复大量浪费,而这份浪费直接限制了 batch size。
为什么”限制 batch size”是致命的?因为吞吐要靠它。
想要吞吐,就要把 batch 做大
先看 GPU 是怎么干活的:权重放在显存里,真正做运算的是计算单元,而计算单元装不下整个模型。所以每算一次前向,都得把用到的数据从显存搬进计算单元。
一层里做的事可以写成 。设输入 是长度 的向量,输出 是长度 的向量,那么权重矩阵 的形状是 ( 行对应输出, 列对应输入)。逐元素写就是:
其中 表示从输入 到输出 的那个权重。数一下两项:
- 计算量: 个权重,每个参与一次乘加,也就是 次乘加。按算力指标的习惯,一次乘加记作 2 次浮点运算,所以是 FLOPs。
- 搬运量:要读权重( 个数)、读输入( 个数)、写输出( 个数)。bf16 下每个数 2 字节,合计 字节。
两项一除,就是这一层的算术强度:
最后的约等号能用,是因为真实模型里 远大于 ——比如 , 是 1670 万,而 只有 8192。输入输出那部分搬运量确实可以忽略,但严格讲它也在分母里(这点我第一版漏了)。
上面只算了一层线性层(投影、FFN 那些)。真正算注意力的时候还要读写 KV cache:prefill 阶段把每个 token 的 K/V 写进去,decode 阶段再把它们读出来——都是额外的搬运量,上下文越长越显眼。先记着,第 4 章会回来算这块。
再对比硬件。以 H100 为例,bf16 算力约 990 TFLOP/s,显存带宽约 3.35 TB/s,比值约 300 FLOP/字节:每搬 1 字节,得做上 300 次浮点运算才不亏带宽。而单请求 decode 只有 1 FLOP/字节。差 300 倍,计算单元绝大部分时间在等数据。
解法是把多个请求的 decode 凑一起跑。批大小为 时,输入从一个向量变成 的矩阵:
- 计算量变成 ——每个权重被 个请求各用一次;
- 搬运量里,权重仍然只读一遍(还是 ),只有输入和输出随 涨。
强度随之变成:
代进具体数字最直观。还是用 这一层:
| 计算量(FLOPs) | 搬运量(字节) | 强度(FLOP/字节) | |
|---|---|---|---|
| 1 | ≈ 1 | ||
| 32 | ≈ 32 | ||
| 256 | ≈ 228 | ||
| 512 | ≈ 410 |
盯着看两列:搬运量几乎没动(从 到 ),而计算量涨了 500 倍。所以 小的时候强度差不多就等于 ; 大了以后输入输出的搬运开始占份量,强度就落后于 (比如 256 只有 228)。
拿 H100 的 300 当门槛, 这一层大概要到 才算真正算力受限。这也是为什么在线服务要把 batch 做大——不是为了让总搬运变小,而是为了让每搬一个字节都配上足够的计算。
但”batch 大”有两个障碍
障碍一:想大,装不下。 batch 越大,KV cache 越多,显存很快就不够了。前面那句 “limiting the batch size” 说的就是这个——浪费掉的显存,本来可以多装几个请求。
障碍二:就算装得下,batch 也会”塌”。 静态批处理的规则是”一批一起跑,等整批都结束才开始下一批”。中途陆续有请求完成,但它们占的位置不会让给新请求——于是越到后面,每一步照常搬一遍权重,能摊到的活跃请求却越来越少。
两个障碍对应两种”空转”,但成因不同:
| 障碍一 | 障碍二 | |
|---|---|---|
| 时间尺度 | 单个 step | 一整批从开始到结束 |
| 表现 | 权重搬运摊不薄,算力用不满 | batch 会塌,尾部算力用不满 |
| 缺的是 | 显存容量 | 动态调度 |
| 解法 | PagedAttention(第 4 章) | continuous batching(第 2、3 章) |
两件事是咬合的:显存决定”能塞多少”,调度决定”塞得满不满”。
补一个容易记混的点:continuous batching 并不是 vLLM 首创。Orca(OSDI ‘22)里提出的 iteration-level scheduling 就是这个思路,vLLM 做的是把它和 PagedAttention 结合在一起。vLLM 真正的核心贡献是”显存”那一半——因为真正卡住 batch size 的,是 KV cache 的显存。第 2 章会细讲。
vLLM 内部的三个角色
上面讲的所有事,在 vLLM 里由三个角色配合完成。为什么偏偏是这三个?因为它们刚好对应前面理出来的三件事:请求怎么一步步往前走、每一批跑谁、显存怎么分。
引擎循环——不停地重复三件事:挑一批请求、跑一次前向、把新生成的 token 拼回各自的序列。整个引擎就是一个 loop。
调度器——每轮循环开始时决定:这一批跑哪些请求、每个给多少 token 的预算;显存不够时还要决定把谁先踢出去、等会儿再放回来。也就是”障碍二”那套动态换人。
KV cache 管理器——管那块显存。谁要用、用多少、用完怎么回收、能不能和别人共用,都归它。也就是”障碍一”里 PagedAttention 落地的地方。
第 5 章会带你看它们在源码里长什么样,现在先把这套配合记在脑子里。
小结
一句话:vLLM 解决的核心问题是 KV cache 的显存管理——它卡住了 batch size,而 batch size 卡住了吞吐。
把这条链串起来:
目标:高吞吐
  └─ 手段:大 batch(摊薄权重搬运,GPU 才不空转)
       ├─ 障碍一:装不下 —— KV cache 显存又大又动态,管不好就浪费
       │    └─ 解法:PagedAttention(按块管理,接近零浪费 + 可共享)
       └─ 障碍二:会塌 —— 请求陆续完成,位置不让给新请求
            └─ 解法:continuous batching(每一步动态换人)
其中 continuous batching 是 vLLM 采纳的思路,不是它发明的。
接下来会从最简单往复杂走:
- 第 2 章:现在只有一个请求。如果有 100 个呢?——批处理。
- 第 3 章:100 个请求怎么排队、怎么决定谁先跑?——调度器。
- 第 4 章:KV cache 那么大,显存怎么分?——PagedAttention。
先不急着看代码。等这三章的直觉建立起来,再回头读源码,会顺很多。
参考资料
- vLLM 0.30.0 源码(后面章节会用)
- Yu et al.,Orca: A Distributed Serving System for Transformer-Based Generative Models,OSDI ‘22
- Aleksa Gordić,《Inside vLLM: Anatomy of a High-Throughput LLM Inference System》,2025-09-05
- Kwon et al.,《Efficient Memory Management for LLM Serving with PagedAttention》,SOSP 2023